





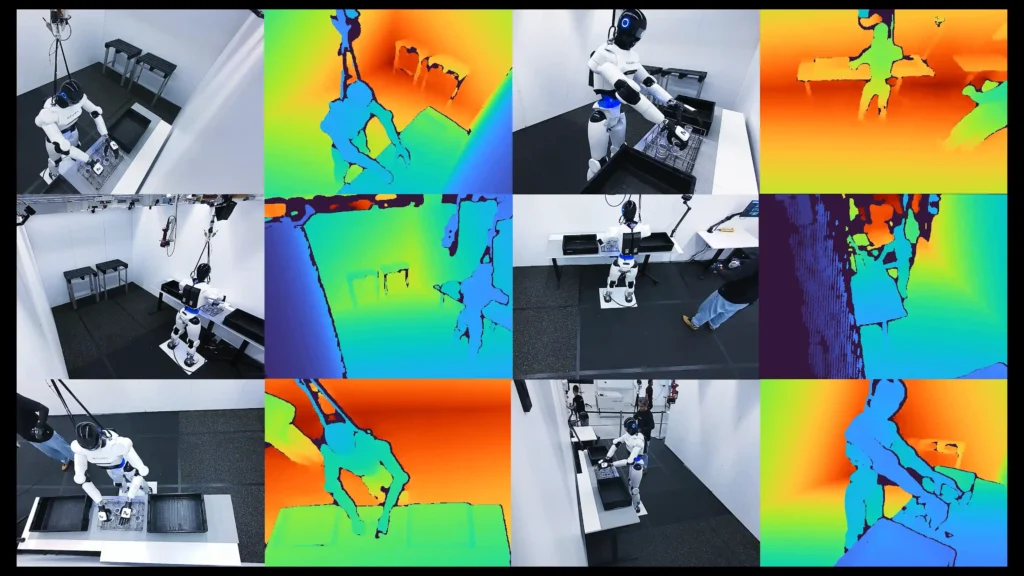
Wenn ein humanoider Roboter lernt, Pakete zu sortieren oder Bauteile zusammen zu setzen, entstehen dabei Daten, die weit über einen einzelnen Trainingslauf hinaus wert sind – und damit unmittelbar die Frage, wem sie gehören. Auch deswegen ist Datensouveränität in europäischen Unternehmen längst auf der Vorstandsagenda angekommen. Der Befund dahinter ist eindeutig: Von Hardware über KI bis hin zu Betriebssystemen sieht sich die Mehrheit der Unternehmen nach eigener Einschätzung weitgehend oder vollkommen abhängig von Technologien, Innovationen oder Dienstleistungen aus Nicht-EU-Ländern, wie beispielsweise die DIHK-Digitalisierungsumfrage 2026 unter knapp 5.000 Unternehmen zeigt.
Wenig verwunderlich ist vor diesem Hintergrund, dass Datensouveränität zu einem Geschäftskriterium geworden ist. Wer Partnerschaften eingehen möchte, muss also souveräne Lösungen anbieten können, und nirgends wiegt das so schwer wie in der kognitiven Robotik, die von Zusammenarbeit bzw. gemeinsamer Datengenerierung lebt.
Das Dilemma der Robotik-Industrie: der gläserne Shopfloor
Sobald kognitive Roboter wie die kognitive MAiRA oder der humanoide 4NE1 trainiert werden, stellt sich für viele die Frage, wem die generierten Daten gehören. Wenn ein KI-gestützter Roboter lernt, ein neues Werkstück zu greifen, entsteht dabei kein beliebiger Datensatz, sondern geistiges Eigentum des produzierenden Unternehmens, das in Griffstrategien, Toleranzen, Taktzeiten und Fehlerbildern steckt. Genau dieses Gelernte macht den eigentlichen Wert aus.
In der kognitiven Robotik verstärkt sich das Thema dadurch, dass ein Roboter besonders zielführend lernt, wenn er die Daten aus vielen realen Fertigungen einbeziehen kann. Wer beiträgt, fürchtet sein Know-how mitzuliefern, und wer nicht beiträgt, erreicht die nötige Datenbasis im Alleingang nicht. Ohne Datenaustausch bleibt die KI also schwach, während unkontrollierter Austausch den Informationsschatz verwässert.
Die Frage kann also nicht lauten, ob Unternehmen Daten teilen, sondern unter welchen Bedingungen sie es tun können, ohne dabei die Kontrolle zu verlieren.
Was ist Datensouveränität?
Der Begriff wird sehr unterschiedlich verwendet, weshalb eine allgemein akzeptierte Definition nicht existiert. Im Kern beschreibt Datensouveränität die Kontrolle über die eigenen Daten und über deren Erhebung, Speicherung und Verarbeitung.
Ein Unternehmen ist folglich datensouverän, wenn es ohne einseitige Abhängigkeit von Dritten entscheiden kann, wer seine Daten erhebt, wo sie liegen und wer sie zu welchem Zweck nutzen darf. Souveränität ist damit in erster Linie eine Frage der Kontrolle und erst in zweiter Linie eine des Standorts. Unerheblich ist der Standort dennoch nicht, denn Daten unterliegen den Gesetzen des Landes, in dem sie erzeugt und verarbeitet werden, und wo sie liegen, entscheidet mit darüber, wer im Zweifel Zugriff verlangen kann.
Anders als der Datenschutz bezieht sich Datensouveränität auf alle Daten und damit auch auf solche ohne Personenbezug, also gerade auf Maschinen- und Sensordaten, Trainingsdaten, Prozesswissen sowie Modelle und Gelerntes.
Abgrenzung: digitale Souveränität, Datensouveränität und Datensicherheit
In der Debatte werden die Begriffe häufig vermischt. De facto ist Datensouveränität ist ein Teilbereich der digitalen Souveränität. Während es bei der Datensouveränität um die Nutzungsrechte an den Daten geht, umfasst die digitale Souveränität die gesamte technologische Handlungsfähigkeit von Mikrochips über Netze und Betriebssysteme bis zu KI-Modellen. Das eine zielt auf Selbstbestimmung über den eigenen Informationsbestand, das andere darauf, Monopole und Erpressbarkeit bei kritischer Technologie zu vermeiden.
Darüber hinaus ist Souveränität nicht unmittelbar mit Sicherheit gleichzusetzen. IT-Sicherheit schützt Daten vor Angreifern, während Datensouveränität die rechtliche und technische Selbstbestimmung darüber beschreibt, wer Daten überhaupt verarbeiten darf.
| Begriff | Worum es geht | Kernfrage | Beispiel |
|---|---|---|---|
| Digitale Souveränität | Gesamte technologische Handlungsfähigkeit – Mikrochips, Netze, Betriebssysteme, KI-Modelle | Bleiben wir bei kritischer Technologie handlungsfähig? | Keine Abhängigkeit von einem einzigen Nicht-EU-Cloud- oder Chipanbieter |
| Datensouveränität | Nutzungsrechte und Kontrolle über die eigenen Daten, auch ohne Personenbezug | Wer darf unsere Daten erheben, speichern und wozu nutzen? | Griffstrategien und Taktzeiten bleiben unter Kontrolle des Betreibers |
| Datensicherheit | Technischer Schutz der Daten vor Angreifern und Verlust | Sind die Daten vor unbefugtem Zugriff geschützt? | Verschlüsselung nach Stand der Technik, Zugriffsmanagement, Backups |
Wann liegt Datensouveränität vor?
Einen Teil der Antwort gibt inzwischen der Gesetzgeber: mit dem EU Data Act , der seit September 2025 gilt, und dem EU AI Act , dessen Pflichten für Hochrisiko-Systeme ab August 2026 greifen. Datensouveränität liegt demnach bei einem Zusammenspiel verschiedener Bedingungen vor:
- Rechtliche Klarheit. Die Eigentums- und Nutzungsrechte an den Daten sind vertraglich eindeutig geregelt, sodass festgehalten ist, wer welche Daten zu welchem Zweck nutzen darf und wer nicht.
- Physische Kontrolle. Die Verarbeitung geschieht dort, wo der Dateneigentümer sie kontrolliert, also on-device, on-premise oder in einer selbstgewählten Infrastruktur.
- Zweckbindung und Zugriffskontrolle. Es ist granular geregelt, welche Rolle, welches System und welcher Partner wann und wofür auf welchen Datenbestand zugreift.
- Territoriale Bestimmtheit. Es ist festgelegt, in welcher Jurisdiktion Daten gespeichert und verarbeitet werden und welchem Recht sie damit unterliegen.
- Nachvollziehbarkeit. Datenflüsse sind protokolliert und auditierbar, wie es der EU AI Act für Hochrisiko-Systeme ausdrücklich verlangt.
- Portabilität und Löschbarkeit. Daten lassen sich exportieren, migrieren und löschen, ohne dass ein Anbieter als Gatekeeper dazwischensteht.
- Trennbarkeit ohne Funktionsverlust. Die Zusammenarbeit mit einem Partner lässt sich beenden, ohne dass der laufende Betrieb zusammenbricht.
Viele Anbieterumgebungen erfüllen die Anforderungen an den Datenstandort und geben dem Kunden dennoch nicht die alleinige Kontrolle über die Schlüssel, sodass der Anbieter technisch zugriffsfähig bleibt. Wer die Bedingungen also nicht nur behaupten, sondern nachweisen will, muss sie in seiner Infrastruktur verankern.
Edge, Hybrid oder Cloud: wo Souveränität technisch entschieden wird
Für diese Entscheidung stehen im Wesentlichen drei Betriebsmodelle zur Verfügung, die sich in der Praxis kombinieren lassen.
Die Public Cloud bietet den größten Funktionsumfang und die einfachste Skalierung, doch die Kontrolle über Zugriff und Verschlüsselung bleibt beim Anbieter, solange der Kunde keine eigene Schlüsselverwaltung durchsetzt. Beim Edge-Computing werden Daten dort verarbeitet, wo sie entstehen, also direkt auf dem Roboter oder in der Fabrik, wodurch die Kontrolle vollständig beim Betreiber bleibt, begrenzt allerdings durch die lokal verfügbare Rechenleistung und den höheren Betriebsaufwand. Hybride Architekturen verbinden beides, indem die sensible Verarbeitung lokal bleibt und nur aggregierte oder anonymisierte Daten in eine Cloud wandern, deren Jurisdiktion bewusst gewählt ist.
Smartes Smart Limbs Konzept
In der kognitiven Robotik setzt NEURA genau das mit seinem Smart-Limbs-Konzept um, das Sensorik und Rechenleistung über den gesamten Roboter verteilt, sodass Entscheidungen dort fallen, wo die Daten entstehen. Zusammengefasst erlaubt das die Modellqualität aus gemeinsamem Training, ohne das Prozesswissen im Rohzustand aus dem Werk zu geben.
Über die Wahl des Betriebsmodells hinaus haben sich mehrere Ansätze etabliert, mit denen Unternehmen Souveränität technisch absichern. Von der Schlüsselverwaltung beim Kunden bis zu Offenen Standards und Schnittstellen wie OPC UA, die die Umgebung wechselbar halten.
Ökosystem entscheidend für Datensouveränität
Daran hängt auch die europäische Wettbewerbsfähigkeit. In den USA und in China entstehen Robotik-Ökosysteme mit hohem Tempo und großem Kapitaleinsatz, während in Europa Faktoren wie die industrielle Tiefe und das über Jahrzehnte gewachsene Prozesswissen den Unterschied machen. Dieser Vorteil zählt allerdings nur, wenn sich solches Wissen teilen lässt, ohne es preiszugeben.
Hinzu kommt ein Effekt, der leicht übersehen wird, denn KI-Modelle werden mit den Daten ihrer Nutzer besser, und wer europäische Fertigungsdaten in außereuropäische Modelle speist, verbessert damit die Algorithmen möglicher künftiger Wettbewerber. Souveränität bedeutet deshalb keine Abschottung, sondern die Fähigkeit, in kritischen Bereichen eigene Kompetenz aufzubauen und handlungsfähig zu bleiben, offen für Handel, Investitionen und internationale Zusammenarbeit.
Ob ein Anbieter datensouverän ist, entscheidet sich damit durch die Architektur seines Ökosystems. Aus diesem Grund denkt NEURA Smart Limbs und Neuraverse als zusammenhängende Architektur. Die Verarbeitung findet dort statt, wo die Daten entstehen. Mit einem Ökosystem dahinter, das Zugriffsrechte technisch statt vertraglich absichert.
